Une donnée que le visiteur n'a pas dite n'est pas une donnée zero-party
Publié le 27 octobre 2026
La règle, en une phrase
Une donnée zero-party est une donnée que le visiteur a dite. Une valeur que l'agent a déduite n'en est pas une, même écrite dans le profil comme si elle avait été déclarée. C'est une inférence, avec un autre régime juridique et un autre coût commercial.
La différence ne se voit pas à l'écran. Elle se voit au premier rappel, quand le commercial ouvre sur un budget que le visiteur n'a jamais évoqué. La définition de Forrester parle d'abord de l'origine de la valeur, pas de la forme de la collecte. Le droit européen traite déjà la donnée déduite comme une donnée à part. Et la seule manière fiable de tenir la promesse est de retirer au modèle la décision d'écrire dans le profil. Il peut proposer une valeur ; le code décide de l'admettre.
L'appel qui commence par une question que personne n'a posée
Le visiteur écrit « je ne sais pas trop par où commencer ». L'agent enchaîne sur la question suivante. Dans le profil, un champ vient d'apparaître : objectif principal, valeur « autre ». Le visiteur n'a rien choisi, et il ne le sait pas.
Deux jours plus tard, un commercial appelle. Il a lu le champ, il l'annonce comme un fait. Les trente premières secondes servent à démentir une donnée que personne n'a produite. La seule information fiable du dossier, c'est que le visiteur ne savait pas.
Le tour ne s'est pas joué au hasard. L'orchestrateur avait imposé un outil d'écriture à cette étape, pour une raison légitime. Sans cette contrainte, un visiteur qui répond « on est une petite boîte de 8 personnes » voyait parfois sa réponse en texte libre perdue. Le modèle, obligé d'appeler l'outil, a rempli le champ de la question en cours avec la seule valeur qui restait. Le code a réclamé une écriture sur un tour qui n'était pas une réponse. Le modèle a obéi.
Ce n'est donc pas une hallucination au sens du modèle qui invente un fait du monde. C'est une écriture forcée là où il n'y avait rien à écrire. La nuance change le correctif : une consigne plus ferme ne répare pas un contrat d'outil mal posé.
Un second chemin donne le même résultat. Un outil de détection du type de visiteur lisait le message d'accueil « je cherche une solution pour mon entreprise » et remplissait parfois les objectifs avec « conversion ». Le moteur, voyant le champ rempli, ne posait plus jamais la question. Une étape de qualification avait disparu, et le dossier portait une intention inventée.
Deux chemins, un même défaut : le modèle sert à la fois à comprendre le visiteur et à écrire le dossier. Tant que ces deux rôles tiennent dans le même appel, chaque progrès sur l'un ouvre une faille dans l'autre.
Ce que « zero-party » veut dire, et pourquoi la définition se brise
Le commercial qui a lu « objectif : autre » n'a pas été trompé par un modèle. Il a lu un champ qui ne dit pas d'où vient sa valeur. Le mot qui manque a une définition précise, et c'est elle qui rend le défaut visible.
Le terme vient de Forrester. La définition n'a pas bougé depuis.
Définition
Une donnée zero-party est une donnée qu'un client partage avec une marque de façon intentionnelle et proactive. Elle peut couvrir les données d'un centre de préférences, des intentions d'achat, un contexte personnel, et la manière dont la personne veut être reconnue [1].
Deux adverbes portent tout le sens : intentionnellement, proactivement. Forrester ajoute une phrase qui tranche, à propos d'un quiz beauté. C'est une donnée que la marque « ne peut ni inférer, ni observer, ni acheter avec certitude » [1]. Ce qui fait sa valeur, c'est précisément qu'elle n'est pas devinable. Une écriture automatique détruit cette propriété.
La plupart des définitions qu'on trouve en premier résultat classent par interface : un sondage, un quiz, un centre de préférences. L'interface est un indice, pas la propriété. Un quiz pré-rempli par un modèle reste un quiz à l'écran. Aucune de ces définitions ne dit ce qui se passe quand le formulaire n'est pas rempli par la personne qui le lit.
Le droit européen a déjà tranché la moitié du sujet. L'article 4§4 du RGPD définit le profilage comme toute forme de traitement automatisé de données personnelles consistant à évaluer des aspects personnels, notamment pour analyser ou prédire [2]. Déduire d'un message qu'un visiteur prépare un achat autour de 300 000 € est exactement cela. Le profilage n'est pas interdit : il est licite avec une base légale, une information correcte, et le droit d'opposition qui va avec. Simplement, ce n'est pas une donnée déclarée. La CNIL trace la même frontière à propos de la portabilité de l'article 20. Elle oppose les données « fournies par la personne » aux « données déduites ou dérivées » [3].
Changer le nom de la donnée change les obligations. L'exactitude, à l'article 5§1(d), demande des données exactes et, si nécessaire, tenues à jour. L'accès, à l'article 15, donne à la personne le droit de savoir ce qui est détenu sur elle. Il couvre aussi l'origine, quand la donnée n'a pas été recueillie auprès d'elle. La rectification, à l'article 16, suppose qu'on sache quoi corriger. Et lorsqu'une inférence révèle une santé, une origine ou une opinion, elle tombe sous les catégories particulières de l'article 9. Le caractère déduit ne dispense pas des conditions que ce régime prévoit : une inférence n'est pas, en soi, une exception [2].
Voilà le coût concret. Un visiteur exerce son droit d'accès et demande d'où vient sa tranche de budget. Si le profil range valeurs dites et valeurs déduites dans les mêmes champs, la réponse honnête est : nous ne savons pas. Le volet conformité de ce sujet est traité dans RGPD et profilage progressif. Ici, la question est plus étroite : qu'est-ce qui, dans un dossier, mérite encore le mot « déclaré » ?
Trois façons de remplir un champ, une seule tient la promesse
Un champ se remplit de trois manières. Elles produisent le même écran, le même export, la même ligne de CRM. Elles ne produisent pas le même dossier.
Origine de la valeur | Ce que le visiteur a fait | Ce que le profil contient | Ce qui se passe au premier rappel |
|---|---|---|---|
Déclarée | Il a répondu, en cliquant ou en écrivant | La valeur qu'il a donnée | Le commercial reprend ses mots |
Déduite | Il a parlé d'autre chose | Une valeur plausible, jamais prononcée | Le commercial l'annonce comme un fait, le visiteur la corrige |
Inventée | Il n'a rien répondu | Une valeur de repli | Personne ne peut dire d'où elle vient |
La troisième ligne se corrige sans débat : aucune valeur ne doit être écrite pour satisfaire un outil. La deuxième demande une décision : l'inférence peut servir, à condition de ne pas prendre la place de la déclaration. La première seule mérite le mot zero-party.
À retenir
Une valeur dont la provenance n'est pas notée au moment de l'écriture devient indistinguable d'une valeur inventée. Le champ a l'air propre dans les trois cas.
Le défaut n'est pas né avec les modèles de langage. MultiWOZ 2.2, un jeu de données de référence pour les agents de réservation, documente des « valeurs hallucinées ». Ce sont des valeurs présentes dans l'état du dialogue sans avoir été prononcées. Elles venaient d'annotateurs humains, qui voyaient la suite de la conversation. Le modèle n'y est pour rien, et le résultat est identique. Les auteurs en comptent 3 128 tours sur 948 dialogues, et corrigent l'état du dialogue dans 17,3 % des énoncés du visiteur, répartis sur 28,2 % des conversations [4].
Leur typologie vaut d'être lue. La première cause s'appelle « Early Markup » : une valeur annoncée par l'agent lui-même, que le visiteur n'a pas encore acceptée. Elle doit être exclue de l'état. Chez nous, le même défaut a pris une autre forme. Le modèle écrivait dans le champ qu'il était en train de demander la valeur qu'il venait de proposer, et le code la mettait de côté comme candidate. Mais l'étape de question cédait la place à une confirmation, et la question à quatre choix restait affichée sans ses puces. Une écriture refusée a suffi à casser l'écran.
Leur recommandation ne porte pas sur la rédaction, mais sur l'interface qui reçoit la valeur. Pour un champ libre, n'accepter qu'une valeur présente dans l'historique de la conversation, et refuser les autres [4].
L'inférence n'est pas le problème, l'écriture l'est
Un agent qui ne déduit rien est un agent qui ne comprend rien. Reformuler un besoin flou, proposer deux solutions du catalogue, choisir la question suivante, repérer un refus, passer la main à un humain. Tout cela est de l'inférence, et tout cela est utile. Aucune de ces opérations n'a besoin d'écrire le dossier.
La frontière utile n'est donc pas « le modèle doit-il inférer ». Elle est : à quel moment une inférence devient une valeur du dossier. Trois palliatifs circulent pour la tenir.
Le premier est le plus solide, et le plus mal compris. Une sortie structurée impose au modèle un schéma JSON : Structured Outputs chez OpenAI, schéma de réponse chez Google, sorties JSON chez Anthropic. Elle garantit un objet conforme, à condition que le fournisseur accepte le schéma. Elle ne dit rien de la vérité de ce qu'il contient. Un banc d'essai de 2026 porte sur 35 documents d'entreprise et 12 867 valeurs annotées. Six modèles de pointe y atteignent 51 % de sorties bien formées, et 4,6 % de champs corrects [5].
Voir les données
| Contrats de crédit (13 champs) | 56.3 (%) |
|---|---|
| Articles scientifiques (16 champs) | 20,8 |
| CV (31 champs) | 18,4 |
| Sport (12 champs) | 12,5 |
| Rapports financiers 10-K (369 champs) | 0 |
Méthode
Taux de champs corrects, agrégés sur six modèles et 35 documents. Chaque modèle est évalué sur 3 086 positions de champs, soit 18 516 évaluations au total. Un champ compte comme correct si sa valeur passe la métrique déclarée par le schéma ; une extraction invalide compte zéro.
Une extraction documentaire sur des schémas de 12 à 369 champs, pas une qualification de visiteur
84 % des évaluations viennent du schéma à 369 champs, à 0 % ; hors ce domaine, le taux remonte à 28 %
Le chiffre mesure la fiabilité d'une extraction, pas la fréquence des inventions
Votre profil compte six champs, pas 369. Le chiffre ne dit donc pas que votre agent se trompera une fois sur deux. Il dit que le respect du schéma répond à la question « la forme est-elle bonne », jamais à « le visiteur l'a-t-il dit ». Le mode contraint a fait baisser les sorties valides de 51 % à 37 % dans la même étude, notamment parce que plusieurs fournisseurs refusent les schémas complexes [5]. L'outil qui garantit la forme n'améliore pas le fond, et peut le dégrader.
Le deuxième palliatif est une phrase dans le prompt : ne jamais inventer une valeur. Une instruction de ce type est probabiliste par construction, et ne se teste pas : on ne peut pas prouver l'absence d'une invention sur un tour qu'on n'a pas prévu. Elle perd surtout dès que le code réclame une écriture sur un tour qui n'est pas une réponse. Le modèle doit appeler l'outil, l'outil exige une valeur, la consigne n'a plus rien à opposer. C'est le mécanisme du premier incident raconté ici. C'est aussi la leçon d'un article précédent sur l'orchestration d'un agent conversationnel : une contrainte de code tient là où une instruction cède.
Le troisième est un second modèle chargé de relire l'extraction du premier. Il attrape les erreurs grossières, il coûte un appel de plus par tour, et il risque de partager l'angle mort du premier sur une valeur plausible. Un juge qui trouve « 300 000 € » cohérent avec le message ne le signalera pas.
Aucun de ces trois outils n'est inutile. Chacun traite sa couche : la forme, la consigne, la relecture. Aucun ne rend une écriture traçable. Tous déplacent l'erreur plus loin dans la chaîne, où elle coûte plus cher à retrouver.
Le code décide ce qui entre dans le profil
La règle tient en une phrase : le modèle formule, le code admet. Cinq mécanismes la rendent concrète.
Elle ne vaut que pour les champs que le moteur demande lui-même. Sur un champ que rien ne garde, une valeur écrite par le modèle entre sans contrôle d'origine, et la règle n'y protège rien. Cette limite est assumée : un champ sans enjeu peut rester libre, un champ qui décide d'un lead ne le peut pas.
La frontière n'est donc pas « important ou pas », tout le monde répondrait important. Elle est « lu par une décision ou pas ». Un champ que l'objectif liste, qui pèse sur l'événement de lead ou sur le routage, doit passer par la garde. Un champ que rien ne lit peut rester libre, et le garder coûterait un tour de confirmation pour rien. Le risque est dans le glissement : un champ libre qui devient un critère de segmentation sans être listé. C'est une décision de configuration, à reprendre chaque fois qu'une nouvelle décision se met à lire un champ.
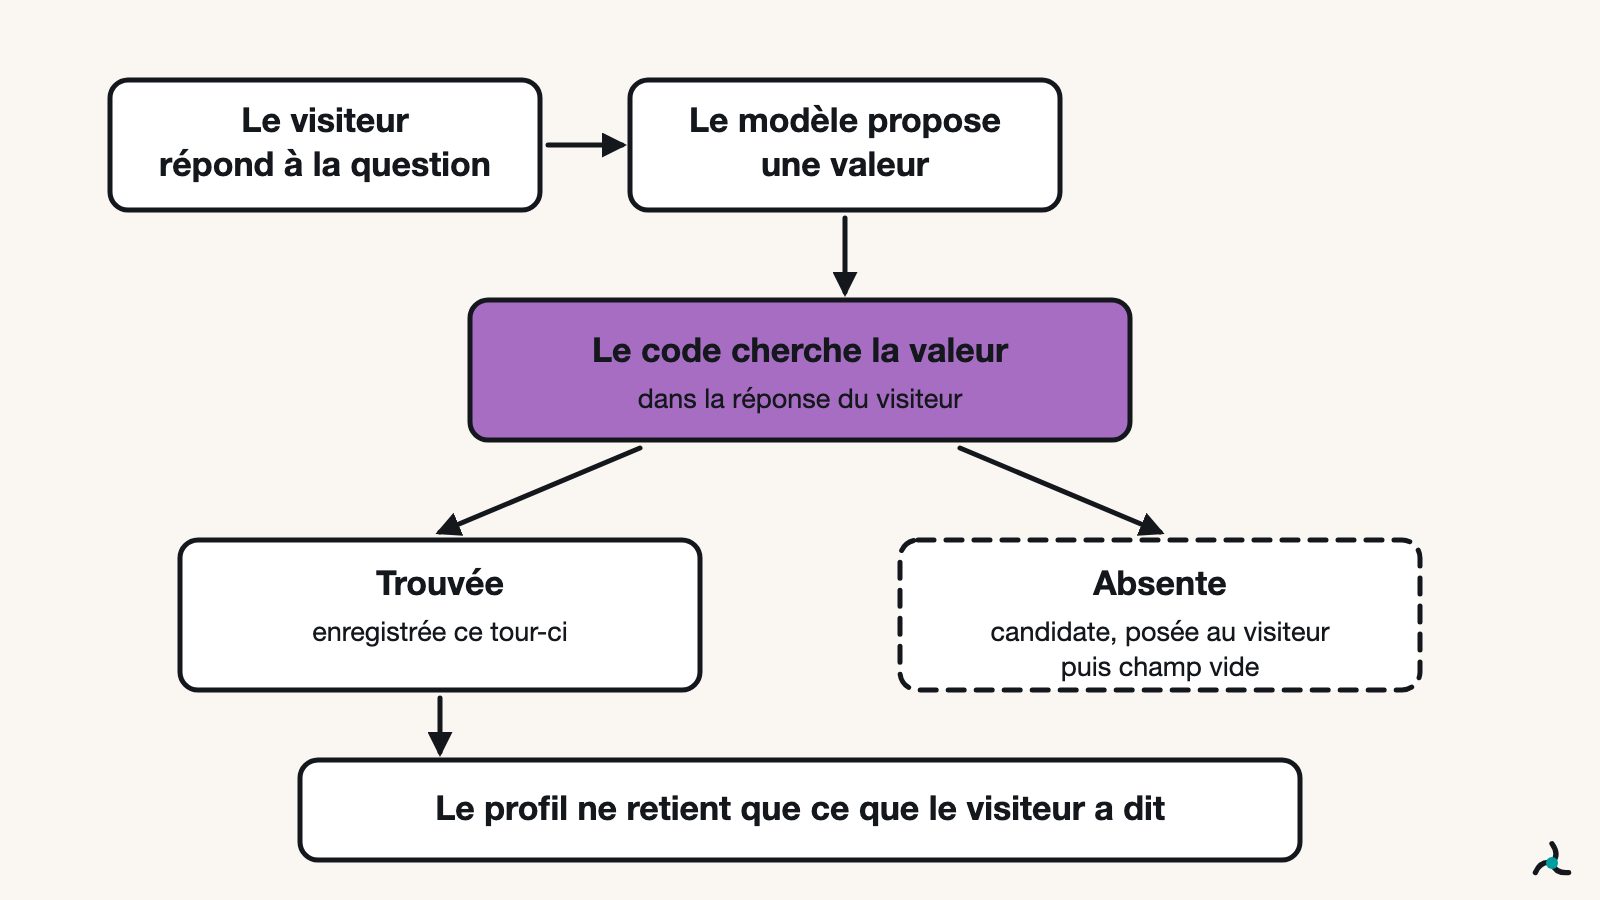
Un clic de bouton s'enregistre avant que le modèle tourne. La valeur envoyée par la puce est comparée à celles que le code a proposées pour le champ en attente. Si elle correspond, elle est écrite par le code, et l'orchestrateur décide sur un profil déjà à jour. Le modèle n'a plus rien à enregistrer, donc plus rien à inventer.
Une valeur donnée avant la question ne vaut pas encore un champ rempli. Le visiteur qui annonce « je veux faire construire une piscine » dès le premier message a bien donné l'information : elle est mise de côté, pas comptée. Une valeur reconnue mot pour mot est admise dès ce tour. Une valeur reformulée est présentée dans la question suivante, puis confirmée ou écartée au tour d'après. Un oui simple l'enregistre sans que le modèle intervienne.
L'ancrage ferme le troisième chemin, pas tous les malentendus. Une valeur écrite après une question doit trouver un appui dans la réponse du visiteur : un mot plein en commun suffit, et tous les chiffres doivent y figurer. « Rénovation » s'appuie sur « rénover », mais « 40 000 » ne s'appuie pas sur « 20 000 ». Le commentaire de la fonction le dit franchement : un indice, pas une preuve. Une négation le trompe : « je ne veux pas rénover » contient « rénover ». Le test mot pour mot la lit et refuse l'enregistrement immédiat, le contrôle d'appui s'arrête aux mots. Un refus mal lu peut donc entrer. La garde protège la provenance, pas le sens. Une valeur sans appui n'est pas jetée : elle devient un candidat, posé au visiteur tant qu'il reste une question à poser. Passé la dernière demande, elle est refusée et le champ reste vide. Le coût est là : une paraphrase sans mot commun, comme « réhabilitation » pour « rénovation », fait perdre un tour. Un champ vide coûte moins cher qu'un champ faux, parce qu'un champ vide se voit.
La confirmation se lit dans le code, pas dans le modèle. Deux règles suffisent. Une liste de formulations vaut oui. Et une phrase qui commence par « oui », « exact » ou une de leurs variantes vaut oui, sauf si elle contient un mot de correction. « Ok » et « d'accord » n'en font pas partie. Ils accusent réception d'un message, ils ne confirment pas une valeur, et le candidat peut être une déduction du modèle. Le prix est assumé : un visiteur qui répond « d'accord » à une confirmation perd le candidat et se voit reposer la question.
Une valeur non confirmée n'est pas un champ rempli. L'objectif de l'application, le compteur de demandes et la règle d'abandon ne lisent que le champ confirmé. Le CRM et l'analytique lisent alors la même chose, et cette chose est ce que le visiteur a dit.
L'effet qu'on n'attendait pas arrive ensuite. La boucle de confirmation, celle qui répond « pouvez-vous me confirmer qu'il s'agit bien d'une réparation ? » à quelqu'un qui vient de l'écrire, est l'image inversée de l'invention. Dans les deux cas, le modèle détient la valeur et n'en est pas sûr : alors il la remplit, ou il la fait répéter. Retirez-lui la valeur, les deux symptômes tombent.
Nous avons essayé trois durcissements de consigne avant d'accepter que le problème était structurel. Chacun a fait baisser la fréquence du défaut. Aucun ne l'a supprimé. Les deux gains nets sont venus du code : la valeur écrite avant la question écartée, la confirmation tranchée sans le modèle. C'est la règle que nous appliquons chez Gamaro, sur les champs que le moteur demande : le profil n'accepte une valeur que si un tour du visiteur la porte.
Ce que ça change pour l'intégrateur
Le test tient en une question par champ : quel tour du visiteur porte cette valeur ? Si la réponse existe, le profil est défendable. Sinon, le champ est une opinion du modèle, et il finira par coûter un rendez-vous.
Le profil ne conserve pas ce tour. La garde vérifie qu'il existait au moment de l'écriture, elle ne l'archive pas. Archiver cette trace est un chantier séparé, et un champ gardé reste défendable sans elle, puisqu'aucune valeur n'y est entrée sans un tour pour la porter.
Trois conséquences. Le premier appel commercial part de ce que le visiteur a dit, pas d'une hypothèse à démentir. La segmentation peut continuer d'utiliser des valeurs déduites, mais comme signal séparé. Un segment construit sur une déduction est une hypothèse, et une hypothèse se vérifie. Enfin, sur un champ gardé, une demande de rectification a une réponse, parce que la valeur vient d'un tour du visiteur et non d'une supposition.
Une donnée déclarée n'est pas une donnée vraie : un visiteur peut se tromper, arrondir, ou tester votre réaction. Un profil honnête laisse donc une correction remplacer une valeur, jamais moyenner les deux.
Le mécanisme de confirmation a sa propre limite : une valeur proposée puis confirmée n'est déclarée que si la question reprend ce que le visiteur a déjà dit. « Vous parlez bien d'une construction ? » après « je veux faire construire une piscine » ne lui fait rien dire de neuf. « Vous cherchez bien autour de 300 000 € ? » sur un chiffre que personne n'a prononcé fabrique un accord, et un accord arraché à une suggestion n'est pas une déclaration.
Trois questions suffisent pour évaluer un agent sur ce point, et aucune ne porte sur le modèle utilisé. D'où vient cette valeur ? Quel tour du visiteur la porte, et l'a-t-il dite ou seulement confirmée ? Que devient le champ quand je ne réponds pas ? Un agent dont la réponse aux trois est « le modèle l'a comprise » est un formulaire déguisé. Un agent qui sait désigner le tour est un profil, pas une vérité. Il ne garantit pas que le visiteur a dit vrai. Il garantit que le dossier ne parle pas à sa place.
Sources
Forrester (Stephanie Liu, Anna Hoskins), « Ask, Don't Interrogate: Best Practices For Collecting Zero-Party Data », 13 mars 2025, forrester.com
Règlement (UE) 2016/679 (RGPD), articles 4§4, 5§1(d), 9, 15 et 16, texte consolidé, EUR-Lex
CNIL, « Droit des personnes et profilage : les spécificités du secteur de l'assurance », 16 juillet 2021, cnil.fr
Zang, X., Rastogi, A., Sunkara, S., Gupta, R., Zhang, J., Chen, J. (2020). MultiWOZ 2.2: A Dialogue Dataset with Additional Annotation Corrections and State Tracking Baselines. arXiv:2007.12720
Ferguson, N., Pennington, J., Beghian, N., Mohan, A., Kiela, D., Agrawal, S., Nguyen, T. H. (2026). ExtractBench: A Benchmark and Evaluation Methodology for Complex Structured Extraction. arXiv:2602.12247